Oui, Gemini 4 Argon existe bien. Google DeepMind l’a officiellement annoncé le 30 septembre 2026. C’est son nouveau modèle « frontier », conçu non pas d’abord comme un chatbot plus sympa, mais pour raisonner longtemps, coder, exécuter des workflows complexes, analyser des documents et des vidéos et surtout travailler en cybersécurité. Et il y a un détail assez inhabituel : Google l’a annoncé… mais presque personne ne peut encore l’utiliser. blog.google


Qui est derrière Gemini 4 Argon ?
Le modèle est développé par Google DeepMind. L’annonce officielle est signée par Koray Kavukcuoglu, Senior Vice President de Google DeepMind et Chief AI Architect de Google. Il dirige notamment le développement des modèles génératifs de DeepMind et leur intégration dans les produits Google.
Parmi les premiers partenaires connus figure Wiz, qui utilise déjà Argon dans son programme « Scan for Good » consacré à la protection d’infrastructures critiques. Google indique également participer au processus volontaire américain permettant aux autorités d’accéder à certains modèles avant leur déploiement généralisé. voir l’Annonce officielle de Google
Qu’est-ce que Gemini 4 Argon change réellement ?
Ce n’est pas simplement « Gemini 3.8 en un peu mieux ». Google positionne maintenant deux approches assez différentes :
| Gemini 3.8 Flash | Gemini 4 Argon | |
|---|---|---|
| Positionnement | modèle rapide et économique | modèle frontier |
| Usage privilégié | volume, agents, code | problèmes très complexes et longs |
| Raisonnement | avancé | raisonnement long horizon |
| Sortie maximale annoncée | 64K tokens | 1 million de tokens |
| DeepSWE v1.1 | 73,7 % | 77,9 % |
| Finance Agent v2 | 61,4 % | 65,4 % |
| Harvey Legal Agent | 10 % | 19,6 % |
| Prix entrée, tarif promotionnel | 0,75 $/M | 2 $/M |
| Prix sortie, tarif promotionnel | 3,75 $/M | 10 $/M |
| Accès aujourd’hui | API, AI Studio notamment | accès très restreint |
Sources Google DeepMind. Google DeepMind
👉 Argon coûte donc environ 2,7 fois plus cher que Gemini 3.8 Flash, mais Google ne vise clairement pas les mêmes traitements.
Le chiffre à ne surtout pas mal interpréter : 1 million de tokens
C’est probablement le point le plus intéressant de l’annonce. Google affirme avoir fait passer la limite de sortie de 64 000 tokens à 1 million de tokens. Cela doit permettre au modèle de poursuivre un raisonnement ou une tâche agentique pendant beaucoup plus longtemps sans devoir interrompre sa trajectoire.
⚠️ Plusieurs articles ont déjà transformé ce chiffre en « fenêtre de contexte de 1 million de tokens ». Ce n’est pas ce que dit Google. Google parle précisément d’une limite de sortie de 1 million de tokens. La société n’a pas encore publié de spécification publique complète indiquant clairement la taille maximale de l’entrée d’Argon. Ses évaluations de contexte long utilisent néanmoins des problèmes allant jusqu’à 1 million de tokens.
Les performances de Gemini 4 Argon
Le tableau publié par Google comporte 19 résultats principaux. Sur ces évaluations, Argon obtient le meilleur résultat sur une large majorité, mais il ne gagne pas partout. Et c’est justement ce qui rend les chiffres intéressants.
Là où Argon impressionne
| Benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| Vals Index – travail professionnel | 68,9 % | 63,1 % | 65,8 % | 67,0 % |
| AutomationBench | 51,3 % | 41,4 % | 31,4 % | 42,5 % |
| Finance Agent v2 | 65,4 % | 53,5 % | 58,9 % | 58,6 % |
| Harvey Legal Agent | 19,6 % | 5,4 % | 6,7 % | 3,8 % |
| DeepSWE v1.1 – code | 77,9 % | 74,1 % | 67,4 % | 74,2 % |
| Vibe Code Bench | 91,9 % | 89,6 % | 90,3 % | 90,3 % |
| LVBench – vidéo longue | 91,7 % | 87,5 % | 79,7 % | 83,7 % |
| GraphWalks 256K–1M | 84,2 % | 71,8 % | 65,0 % | 66,8 % |
Ce tableau est issu directement de Google DeepMind. Google DeepMind
Particulièrement intéressant pour les entreprises : AutomationBench, développé autour de workflows professionnels automatisés, passe à 51,3 %, contre 42,5 % pour Claude Opus 5.5 et 41,4 % pour GPT-6 Astra dans le tableau de Google.
Cela donne probablement l’un des meilleurs angles éditoriaux : Argon n’est pas seulement meilleur pour répondre, il est conçu pour travailler longtemps.
Mais Argon n’écrase pas GPT et Claude
Voilà la partie que les communiqués enthousiastes risquent d’oublier.
- Sur FrontierSWE v2, Argon obtient seulement 55 %, contre 65,5 % pour GPT-6 Astra et 62,3 % pour Claude Opus 5.5.
- Sur Terminal-bench 4.0, Claude Opus 5.5 atteint 66,4 %, contre seulement 57,4 % pour Argon.
- Sur PostTrainBench, Opus 5.5 reste devant avec 49,3 %, contre 45,3 %.
- Sur Terminal-Bench Science, GPT-6 Astra atteint 68,1 %, contre 57,6 % pour Argon.
Enfin sur OSWorld 2.0, qui teste l’utilisation d’un ordinateur, GPT-6 Astra obtient 72,6 %, devant Argon à 69,2 %. Google
🛡️ La cybersécurité est au cœur du modèle
Argon peut, selon Google :
détecter une vulnérabilité → la confirmer → produire un correctif → vérifier ce correctif.
Il peut également pratiquer du pentest « black box », donc analyser une application Web à partir de son comportement sans disposer de son code source. Google affirme que Wiz et Argon ont ainsi identifié une vulnérabilité critique dans un logiciel de santé utilisé par des hôpitaux, vulnérabilité qui avait échappé à d’autres modèles avancés.
Et c’est précisément pour cela que Google ne distribue pas immédiatement toutes les capacités du modèle.
Pourquoi Google ne donne-t-il pas Argon à tout le monde ?
Parce que le même modèle capable de trouver automatiquement une faille peut évidemment aussi être utilisé pour… trouver automatiquement une faille. Google a donc créé le Fairwind Program, destiné dans un premier temps à des organismes et professionnels de cyberdéfense jugés fiables. Ces partenaires peuvent accéder à des capacités cyber beaucoup plus larges.
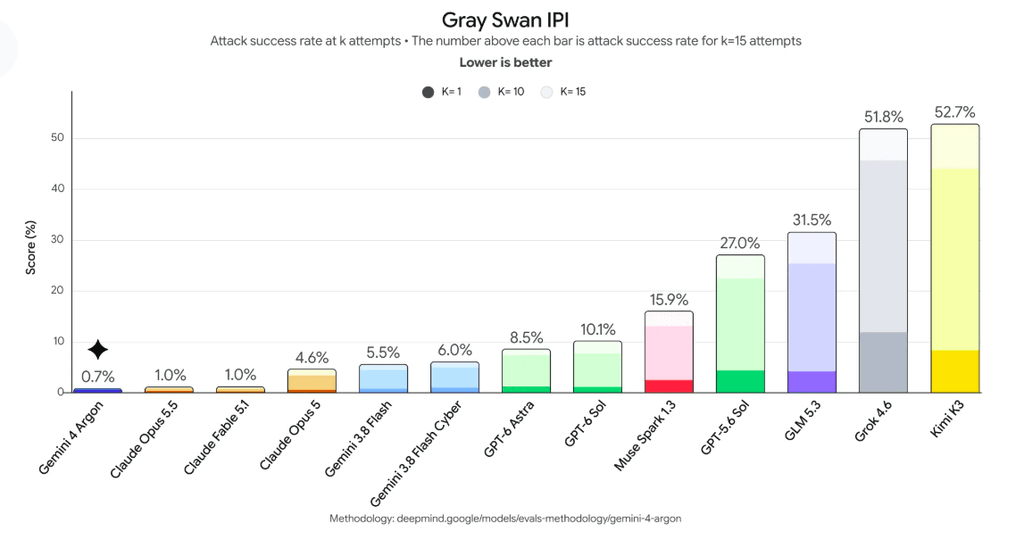
Google renforce parallèlement quatre dispositifs : prévention des usages malveillants, défense contre les prompt injections, surveillance de comportements d’agents qui s’écarteraient de la demande et durcissement des environnements sandbox dans lesquels ils opèrent.
Google affirme même qu’Argon est son modèle le plus robuste jusqu’ici contre les indirect prompt injections. Google DeepMind
Comment accéder à Gemini 4 Argon aujourd’hui ?
Au 6 octobre 2026 : pour une utilisatrice française normale, la réponse est essentiellement “pas encore”.
Le calendrier annoncé est :
maintenant → partenaires cyber du Fairwind Program et testeurs sélectionnés
ensuite → clients payants de la Gemini API
puis → abonnés Google AI Ultra
plus largement → développeurs, entreprises et consommateurs.
Google ne communique pour le moment aucune date précise de disponibilité générale.
Et surtout, posséder aujourd’hui un abonnement Google AI Ultra ne signifie pas qu’Argon apparaît déjà automatiquement dans Gemini. Je n’ai par ailleurs trouvé aucun identifiant API public officiel d’Argon dans la documentation développeur accessible actuellement. Il faudra donc surveiller l’ouverture de la Gemini API.
Combien coûtera Argon ?
Le détail mérite un gros astérisque.
| API Gemini 4 Argon | Tarif |
|---|---|
| Input | 2 $ / million de tokens |
| Output | 10 $ / million |
| Input mis en cache | réduction de 95 % |
| Après période de lancement | 4 $ input / 20 $ output |
Google n’a pas indiqué dans son annonce la date de fin de la période promotionnelle. Donc 2/10 dollars n’est pas son prix définitif. C’est important car beaucoup d’articles ont déjà repris uniquement ce tarif.
Quelques usages internes assez spectaculaires
Google fournit plusieurs exemples intéressants qui évitent de rester dans les benchmarks.
Des agents Argon ont analysé les données de profiling des datacenters Google et identifié des optimisations qui devraient libérer plus de 300 TiB de mémoire, Google estimant le potentiel total entre 500 TiB et 1 PiB.
Argon travaille aussi sur la migration de très gros projets C/C++ vers Rust, jusqu’au noyau Zircon de Fuchsia, avec plus de 800 000 lignes de code concernées dans certains projets.
Sur le décodeur vidéo open source libgav1, Argon a notamment retravaillé 32 000 lignes de code SIMD, Google indiquant que le résultat fonctionne 2,7 fois plus vite que le port Rust précédent, à sortie vidéo identique.
Ce sont des résultats Google et non des reproductions indépendantes. À présenter comme tels.
Et les tests indépendants ?
C’est encore le point faible du dossier.
L’accès étant extrêmement restreint, nous n’avons pas encore des dizaines de tests indépendants permettant de confronter les annonces de Google.
- Vals AI, qui est indépendant du constructeur, classe toutefois Argon premier sur son Finance Agent v2 avec 65,40 %, devant notamment Gemini 3.8 Flash à 61,44 %. Vals AI
- Artificial Analysis lui attribue actuellement 53 points sur son Intelligence Index, ce qui le place parmi les modèles de tête de son classement, mais pas seul sur une autre planète. Artificial Analysis
Autre précaution importante : Google explique dans sa méthodologie que certains scores d’Argon sont calculés par ses équipes alors que certaines performances concurrentes proviennent des fournisseurs ou de leaderboards publics. Il ne s’agit donc pas systématiquement d’un grand test parfaitement homogène réalisé par un laboratoire indépendant.
Ce que Google ne nous dit pas encore
Google n’a pas encore communiqué publiquement : le nombre de paramètres, l’architecture précise du modèle, sa véritable vitesse en production, la consommation nécessaire à ses raisonnements très longs, la date d’ouverture générale, un identifiant API public définitif ni un calendrier précis pour la France.
Je ne vois pas non plus encore de Model Card Gemini 4 Argon publiée dans l’index officiel des Model Cards de Google DeepMind, contrairement à Gemini 3.8 Flash. Google a en revanche publié un document détaillant la méthodologie de ses benchmarks. Google DeepMind
A lir aussi
Les IA frontier de l’été 2026 : quel modèle pour quoi ? – IA Pratique
L’AGI est-elle arrivée avec GPT-6 Astra ? – IA Pratique
Page officielle Gemini 4 Argon – Google DeepMind